

AI 모델 선택
모델 카드 중 하나를 고르면 그 모델로 분석이 실행됩니다. 선택하지 않으면 기본 모델을 씁니다. 워크플로우 수정 화면에서도 “선택된 AI 모델이 없어 기본 모델이 사용됩니다”로 표시됩니다.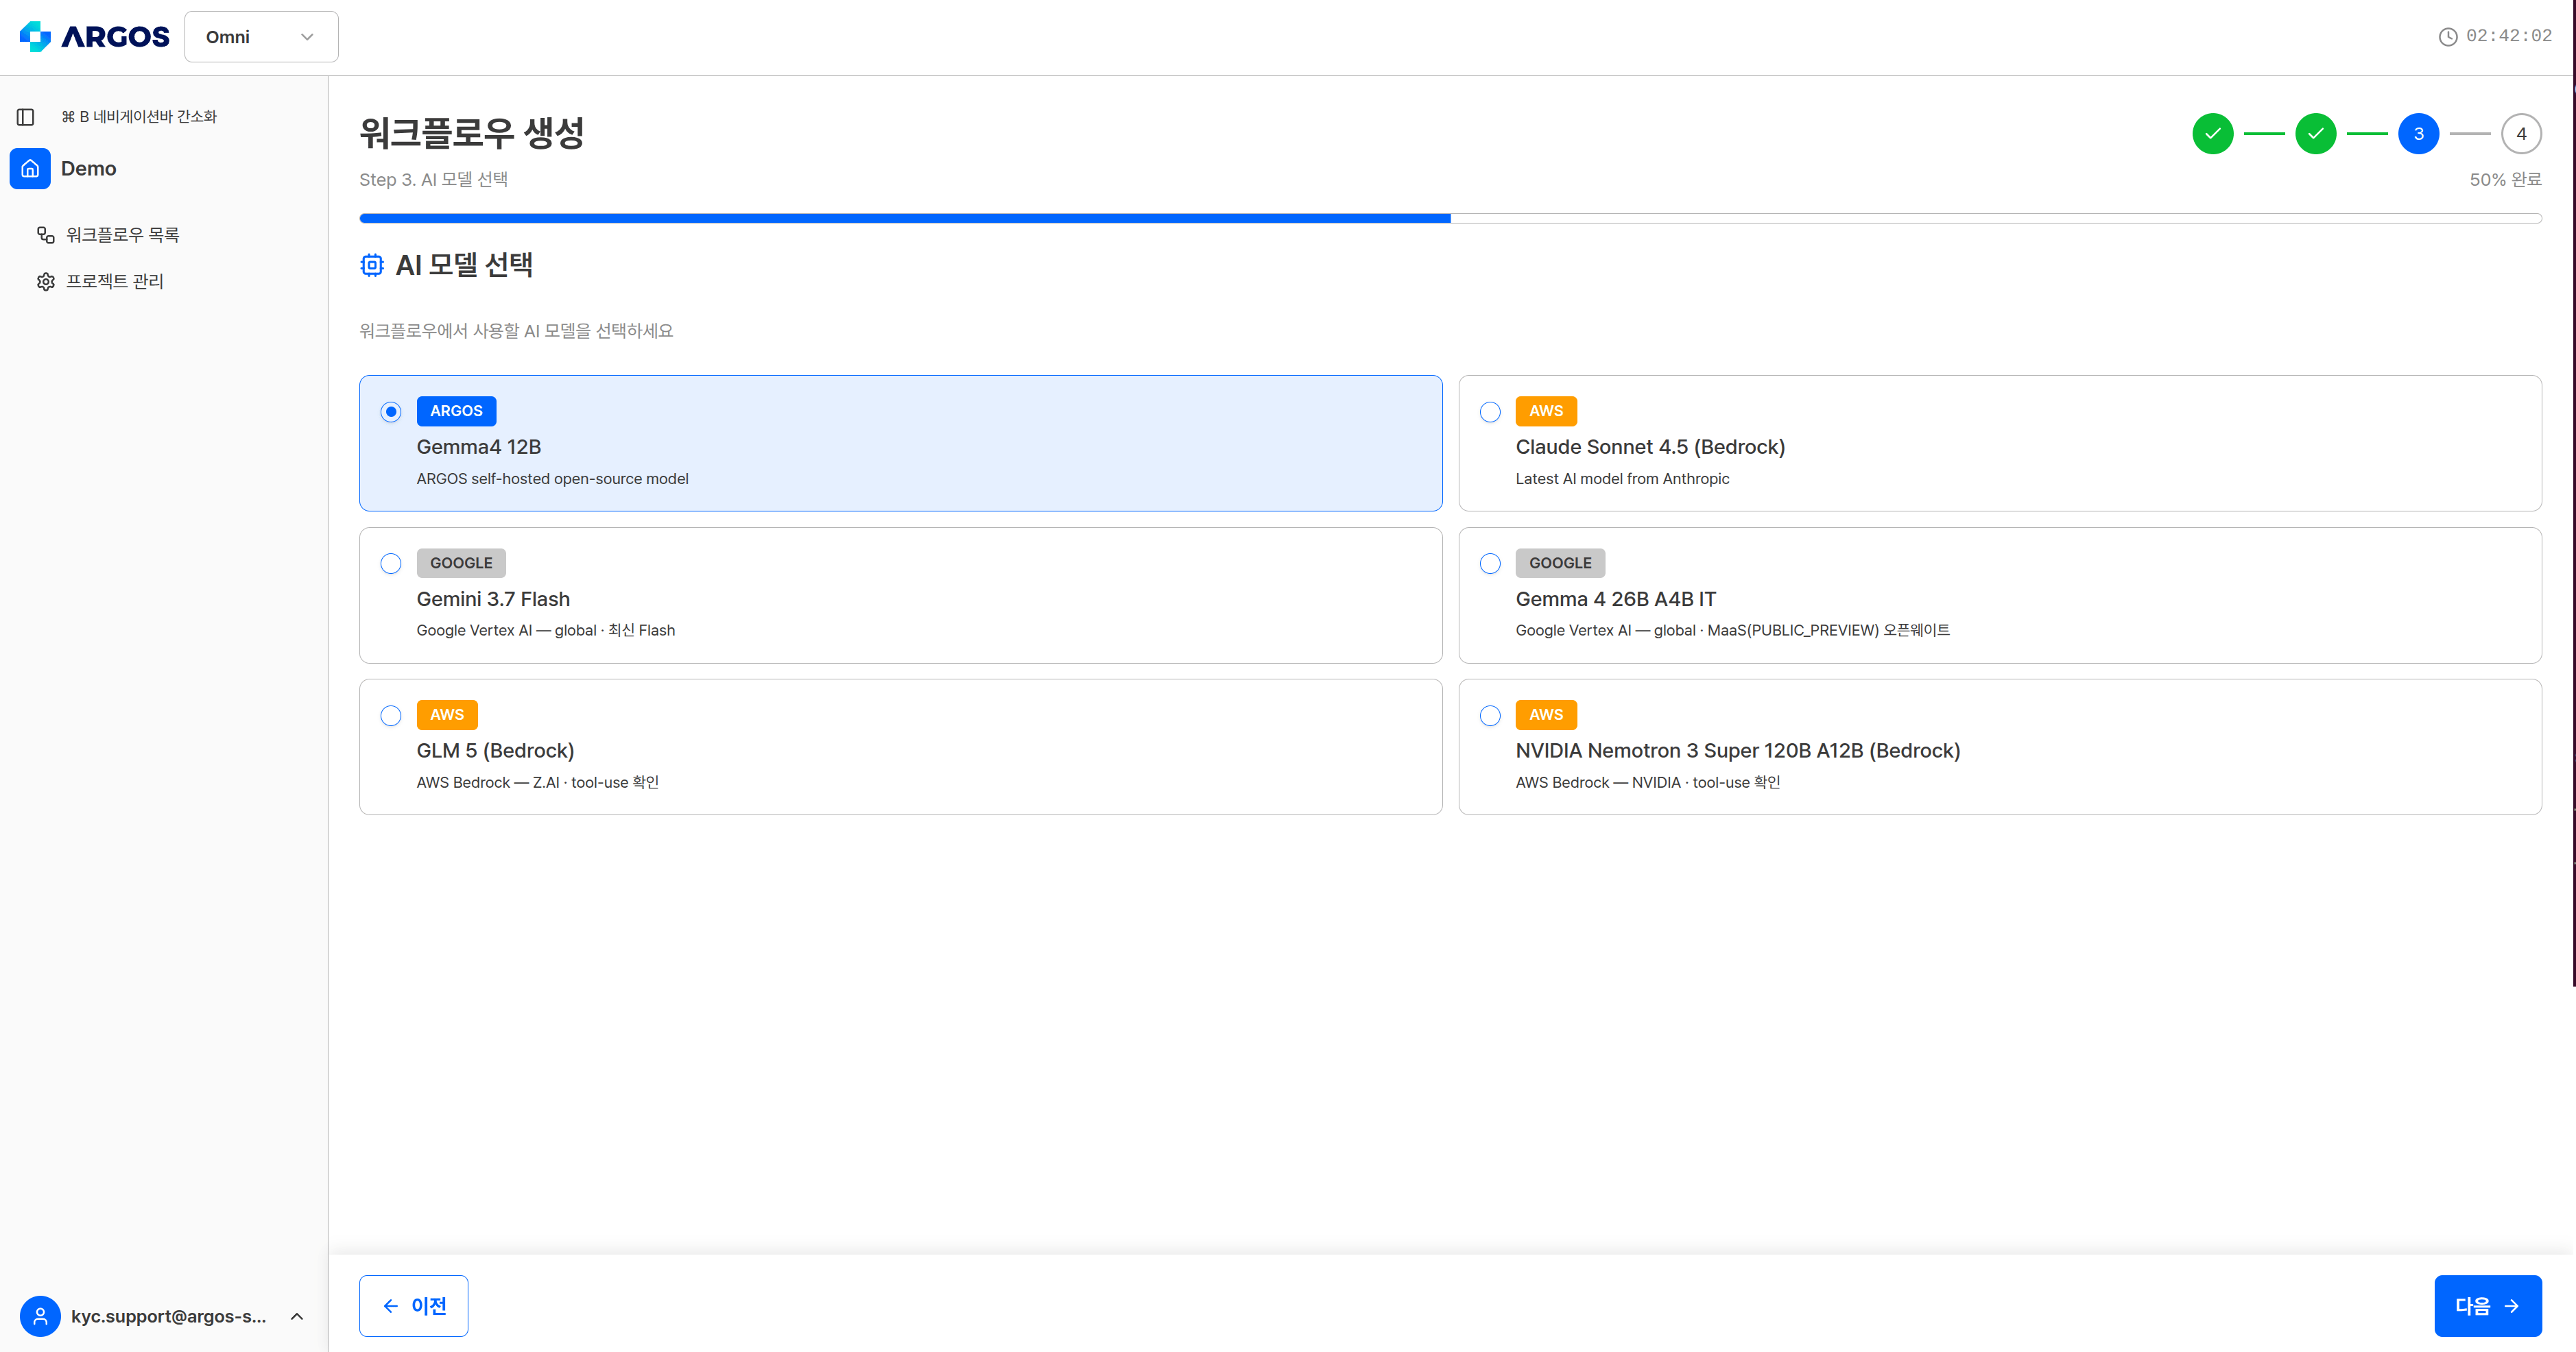
3단계 — AI 모델 선택. 지정하지 않으면 기본 모델을 사용합니다.
고를 수 있는 모델
분석 1건의 기본 단가는 모델마다 다릅니다. 아래 단가에는 스텝 5개까지 포함되고, 6번째 스텝부터 가산이 붙습니다 — 크레딧이 차감되는 방식. 엔진 호출 크레딧은 여기에 별도로 더해집니다.
데이터가 ARGOS 인프라 안에서만 처리되어야 하는 경우 Gemma4 12B를 사용하세요. ARGOS가 직접 호스팅하는 모델입니다.
선택 결과는
GET /workflows/:workflowId의 aiModelId · aiModel에서 확인할 수 있습니다.
엔진은 자동으로 배정됩니다
정책을 저장하면 Omni가 정책을 해석해 플레이북 액션을 만들고, 각 액션에 필요한 엔진을 연결합니다. 실행 순서도 함께 정해지므로 종속성을 직접 설정할 필요가 없습니다. 예를 들어 “대표자 성명으로 AML 스크리닝을 수행합니다”라는 조항은execute_aml_screening 액션이 되고, 여기에 AML Search - Person 엔진이 붙습니다. “지분율 합계가 100%를 초과하면”처럼 외부 조회가 필요 없는 조항은 액션만 만들어지고 엔진은 붙지 않습니다. 액션 이름은 생성할 때마다 달라집니다.
배정 결과는 두 곳에서 확인합니다.
배정된 엔진을 바꾸려면 워크플로우 수정하기의 Step 엔진 편집을 사용하세요.
엔진 카탈로그
각 엔진의 설명은 Step 엔진 편집 화면에서도 확인할 수 있습니다 — 워크플로우 수정하기.
- KOR 엔진은 한국 사업자·계좌만 지원합니다. Address Validation의 지원 지역 40개에는 한국이 없습니다. 대상 국가가 맞지 않으면 엔진이 배정되지 않거나 호출이 실패하므로, 정책을 쓸 때 검증 대상이 어느 나라인지 함께 적어 두세요.Text Verifier
문서 텍스트만으로 판단하는 엔진입니다. 외부 데이터베이스를 조회하지 않고 프로파일에 올린 아이템만 씁니다. 대부분의 워크플로우에서 가장 많이 실행됩니다.
하는 일은 값 추출, 문서 간 필드 대조, 필수 항목 완전성 검사, 정책 준수 판단입니다. 결과는
extractedData(출력 스키마 구조)와 agentAuditLog.steps[]에 남습니다.
AML Search - Person
외부 감시 목록을 조회하는 엔진입니다. 도구 호출은agentAuditLog.steps[].mcpcalls[]에 기록됩니다.
입력 — 에이전트가 문서에서 뽑아 전달합니다.
매칭 점수 — 필드별 점수의 평균입니다. 이름은 문자열 거리 알고리즘과 별칭 라이브러리로, 생년월일·국적은 정확 일치 100% / 부분 일치 80%로 계산합니다.
결과 상태
위험 아이콘 — 매칭된 대상은 아래 코드로 분류됩니다.
데이터베이스 소스와 코드 상세는 AML 데이터베이스 소스 및 코드에 있습니다.
결과를 어디서 보나
엔진 실행 결과는 분석 응답의 세 곳에 남습니다.
읽는 방법은 분석 결과 읽기에 있습니다.